RAG — це коли AI не відповідає «з голови», а спершу шукає у ваших документах: регламентах, договорах, прайсах, інструкціях. Знайдені фрагменти він отримує разом із запитанням і будує відповідь лише з них. Тому чат-бот з базою знань називає вашу ціну й ваш строк доставки, а не середні по інтернету, і показує, з якого документа це взяв.
Нижче — як це влаштовано всередині, коли RAG не потрібен і вистачить готового інструмента, типові помилки та ціни. Як виглядає готове рішення для команди, показано на сторінці AI-асистента за документами компанії.
Що таке RAG: визначення і звідки термін
RAG (retrieval-augmented generation) — це архітектура, у якій мовна модель будує відповідь не лише зі своїх загальних знань, а з фрагментів ваших документів, знайдених пошуком під конкретне запитання.
Назву запровадили дослідники Facebook AI Research (нині Meta AI) з колегами у статті 2020 року: вони поєднали мовну модель із пошуковим індексом Вікіпедії, щоб вона точніше відповідала на фактичні запитання. Відтоді це стандартний спосіб дати моделі знання конкретної компанії.
У назві три слова, і кожне — окремий крок:
- retrieval — пошук: система знаходить у базі фрагменти, близькі за змістом до запитання;
- augmented — доповнення: ці фрагменти додають до запиту, який отримує модель;
- generation — генерація: модель формулює відповідь, спираючись на них.
Найпростіше порівняння — іспит із відкритим конспектом. Мовна модель — це студент, який добре формулює, але ваших регламентів ніколи не бачив. RAG дозволяє йому перед кожною відповіддю зазирнути в конспект. Якщо в конспекті помилка або потрібної сторінки немає, помилиться й студент.
З цього випливають три практичні речі:
- Знання оновлюються без перенавчання. Замінили файл у папці — після синхронізації асистент відповідає вже за новою версією.
- Відповідь можна перевірити. До неї додається назва документа й пункт, тож людина не мусить вірити на слово.
- Якість залежить від пошуку не менше, ніж від моделі. Якщо система знайшла не той фрагмент, найсильніша модель відповість неправильно — упевнено й гарною мовою.
У статті що таке AI-агент простими словами ми називали знання однією з п’яти складових агента. RAG — це якраз про неї.
Як працює чат-бот з базою знань: шлях одного запитання
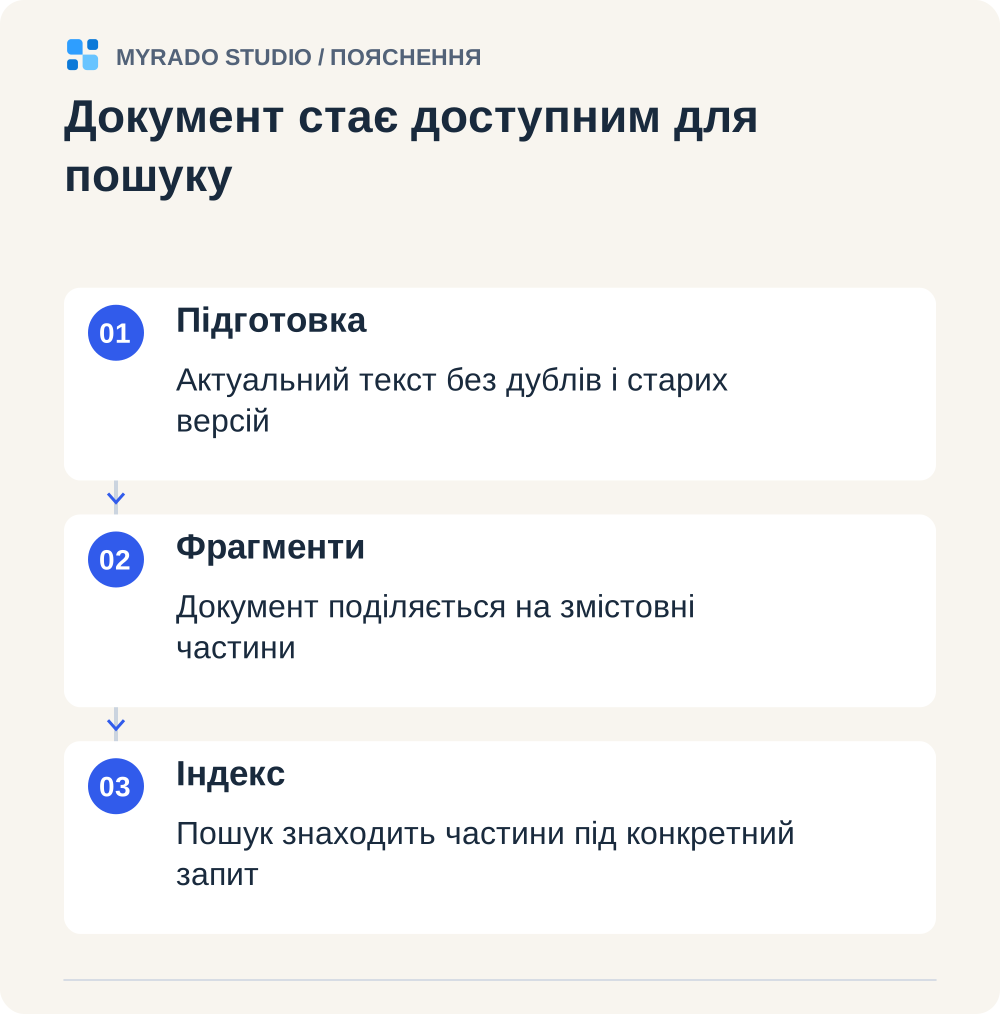
Робота ділиться на два етапи. Підготовка бази (кроки 1–4) виконується один раз і повторюється, коли документи змінюються. Відповідь на запитання (кроки 5–8) — щоразу, коли хтось пише боту.
| Крок | Що відбувається | Де найчастіше ламається |
|---|---|---|
| 1. Збір документів | Система забирає файли з Google Drive, Notion, PDF-архіву чи сайту | У базу потрапляють застарілі версії та чернетки |
| 2. Розбиття на фрагменти | Текст ділять на шматки по кілька сотень токенів: абзац, пункт, рядок таблиці | Таблицю чи пункт розрізано навпіл, фрагмент лишився без заголовка |
| 3. Ембединги | Кожен фрагмент перетворюють на вектор — набір чисел, що передає зміст | Модель ембедингів погано розуміє українську, артикули й скорочення |
| 4. Індекс | Вектори зберігають у векторній базі; поруч працює звичайний пошук за словами | Немає метаданих: дати, відділу, рівня доступу |
| 5. Пошук | На запитання система знаходить зазвичай 5–20 найближчих фрагментів — за змістом і за точними словами | Знайдено схоже за темою, але не той пункт |
| 6. Переранжування | Окрема модель пересортовує знайдене й лишає найдоречніше | Крок пропускають, щоб заощадити |
| 7. Генерація | Модель отримує запитання, фрагменти й інструкцію: відповідай лише з наведеного й посилайся на джерело | Немає правила «не знаєш — скажи», і модель домислює |
| 8. Журнал | Запитання, знайдені фрагменти й відповідь зберігаються для перевірки | Журналу немає, тож помилку нема на чому показати |
Кілька пояснень до таблиці.
Ембединги потрібні, щоб шукати за змістом, а не за збігом слів. «Відпустка частинами» і «розділити відпочинок на два тижні» не мають спільних слів, але їхні вектори близькі — тому система знайде потрібний пункт регламенту.
Векторна база — це сховище таких векторів. У брифах, які ми аналізували, замовники найчастіше називають pgvector, Qdrant і Chroma. Для більшості компаній вибір бази важить менше, ніж якість розбиття документів на фрагменти.
Гібридний пошук поєднує пошук за змістом із пошуком за точними словами. Вектори добре ловлять сенс, але гірше — артикул «KT-2207», номер договору чи прізвище. Тому в робочих системах працюють обидва способи одразу.
Наскільки важлива ця «кухня», показують дані Anthropic за вересень 2024 року. Коли до кожного фрагмента додавали короткий контекст і поєднували векторний пошук із пошуком за словами, частка запитів, у яких потрібний фрагмент не потрапив до двадцяти найкращих, зменшилася на 49%. З переранжуванням — на 67%. Модель, яка пише відповідь, при цьому не змінювалася.
Одне запитання крок за кроком
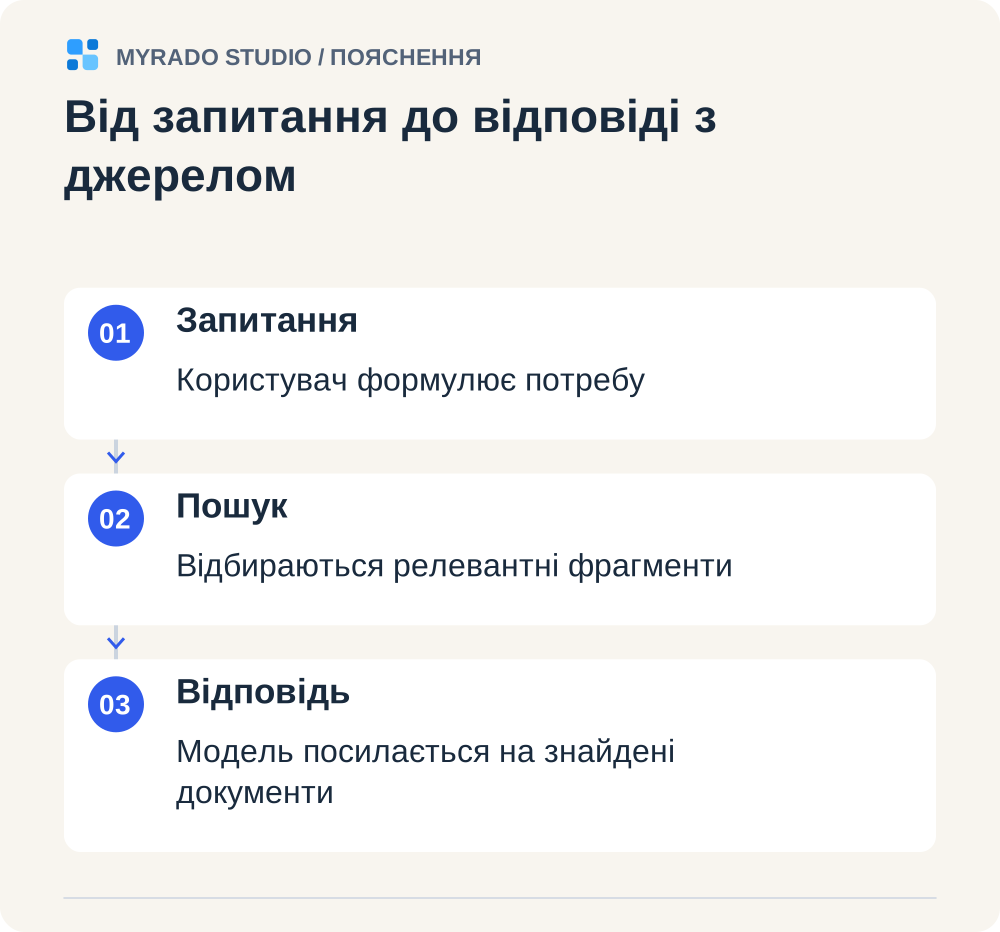
Приклад умовний: магазин, документи й клієнт вигадані. На сайті магазину кавового обладнання клієнт пише в чат: «Чи можна оплатити кавомолку частинами і яка на неї гарантія?»
- Бот для клієнтів має доступ лише до публічних документів: умов оплати, гарантії, доставки. Внутрішніх регламентів і договорів із постачальниками в його базі немає.
- Пошук знаходить три фрагменти: розділ «Оплата частинами» з умов оплати, пункт про гарантію на кавомолки й загальні гарантійні умови.
- Модель відповідає двома реченнями й додає посилання на обидві сторінки.
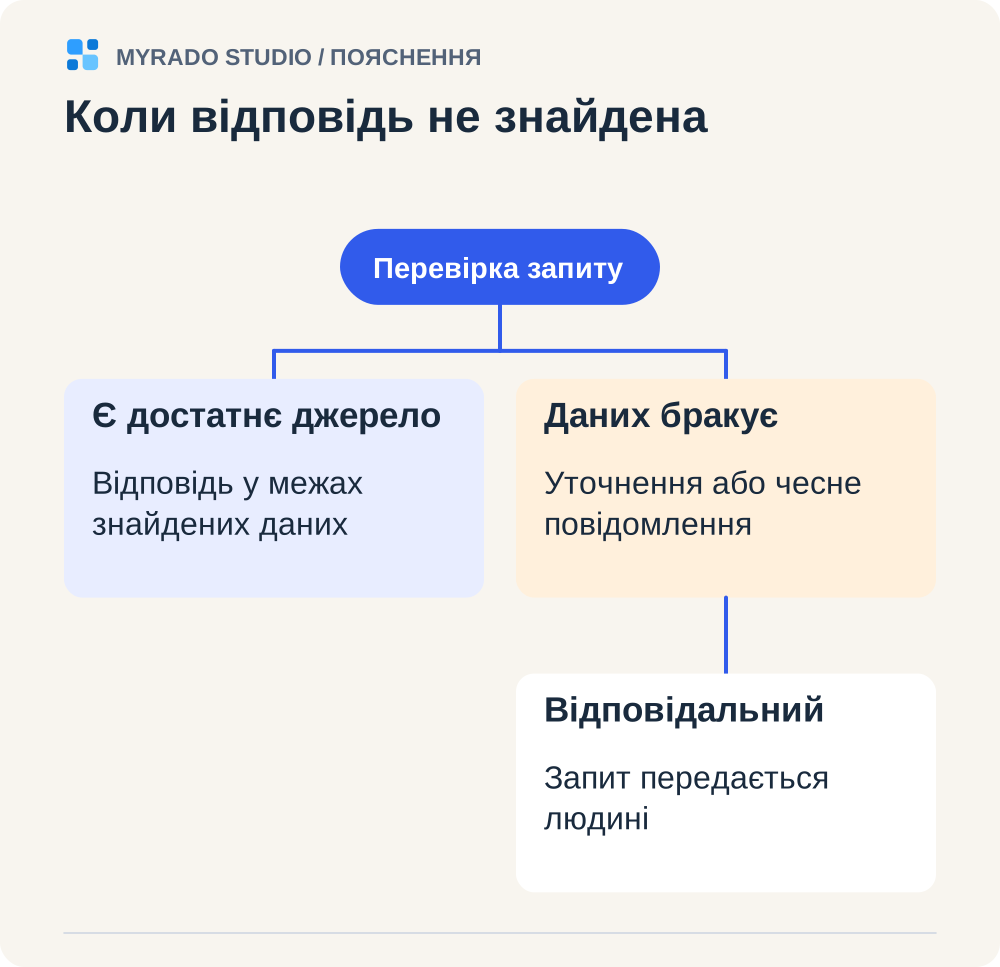
- Клієнт питає далі: «А вона підійде до моєї кавоварки?» У документах про сумісність нічого немає. Бот так і каже й передає розмову менеджеру з коротким резюме.
RAG, «усе в промпт» чи донавчання: що обрати
RAG — не єдиний спосіб навчити AI відповідати за вашими документами, і не завжди найкращий.
| Усе в промпт | Готовий інструмент | RAG | Донавчання (fine-tuning) | |
|---|---|---|---|---|
| Як це виглядає | Увесь текст бази щоразу передається моделі разом із запитанням | NotebookLM, проєкти в ChatGPT чи Claude: завантажили файли й питаєте | Система сама шукає потрібні фрагменти й передає моделі лише їх | Модель додатково тренують на ваших прикладах |
| Коли підходить | База до кількох сотень сторінок | Одна людина чи невелика команда | Сотні й тисячі документів, часті зміни, різні доступи | Потрібен особливий стиль чи формат, а не нові факти |
| Оновлення знань | Замінили текст — готово | Зазвичай файли оновлюють вручну | Синхронізація з джерелом | Нове тренування |
| Посилання на джерело | Якщо попросити в інструкції | Є, у межах інструмента | Так, до документа й пункту | Немає |
| Доступи за ролями | Немає | На рівні акаунта чи проєкту | Так | Немає |
| Вартість запиту | Росте разом із базою | Підписка | Невелика: модель читає лише знайдене | Тренування й запити |
Орієнтир дала Anthropic у тій самій публікації 2024 року: якщо база знань менша за 200 000 токенів — це приблизно 500 сторінок, — її можна цілком передавати моделі, і RAG не потрібен. Відтоді контекстні вікна зросли: в актуальних моделей Claude це до 1 млн токенів (документація Anthropic, жовтень 2026 року). Але «влазить» не означає «вигідно»: що більше тексту в кожному запиті, то дорожча й повільніша кожна відповідь, а розмежувати доступи так не вийде.
Готові інструменти мають власні межі. Наприклад, у NotebookLM одне джерело — це до 500 000 слів або файл до 200 МБ (довідка Google, жовтень 2026 року).
Донавчання часто плутають із RAG. Воно змінює поведінку моделі — тон, формат, термінологію, — але погано підходить для фактів, які змінюються. Щоб оновити прайс, модель довелося б тренувати заново, а послатися на документ вона не зможе.
Коли RAG не потрібен і що можна зробити самому
Розробка асистента за документами виправдана не завжди. Ось чотири ситуації, де вона зайва.
Документів небагато, і користується ними одна команда. Спробуйте готовий інструмент:
- Зберіть актуальні версії документів в одну папку.
- Завантажте їх у NotebookLM або в проєкт у ChatGPT чи Claude.
- Поставте 20–30 запитань, які працівники справді ставлять, і перевірте кожну відповідь за джерелом.
- Якщо результат влаштовує — можливо, більше нічого не потрібно.
Перед завантаженням договорів і персональних даних прочитайте умови свого тарифу: правила зберігання й використання даних у різних сервісів і планів різні.
Потрібен FAQ-бот на 30–50 запитань. Таблиця «запитання — відповідь» цілком уміщається в інструкцію бота, і пошук тут не потрібен. Вистачить конструктора з AI-блоком або простого чат-бота для сайту.
Відповідь живе в системі, а не в документі. Залишок на складі, статус замовлення, борг клієнта — це запит до CRM чи 1С/BAS через API, а не пошук у текстах. Такі задачі описано на сторінці інтеграцій AI з 1С, BAS і CRM.
Документи суперечать одне одному. Якщо на сайті одна ціна, а в прайсі інша, асистент чесно знайде обидві. Спершу варто навести лад у документах.
А ось ознаки, що RAG потрібен:
- документів сотні й більше, і вони оновлюються щотижня;
- різні люди мають бачити різне: продавець — прайс, бухгалтер — договори;
- у відповіді потрібне посилання на документ і пункт;
- асистент має відповідати в Telegram, Slack чи на сайті, а не в особистому акаунті працівника;
- керівнику потрібен журнал: що питають і на що в документах немає відповіді.
Типові помилки в проєктах з базою знань
- Завантажили все підряд. Чернетки, старі версії й дублікати потрапляють у базу нарівні з чинними документами, і асистент цитує те, що знайшов першим.
- Скани без розпізнавання. PDF без текстового шару для пошуку порожній. Скани спершу розпізнають, і що чіткіший скан, то краща відповідь.
- Прайси й таблиці порізано на шматки. Назва товару опинилася в одному фрагменті, ціна — в іншому. Таблиці краще зберігати як таблиці й шукати в них точно, а не «за змістом».
- Немає прав доступу. В одному з брифів на біржі замовник окремо вимагав відкликати доступ у звільнених працівників. Про ролі варто подумати до запуску, а не після першого витоку.
- Якість оцінюють «на око». Один замовник порахував: із 81 відповіді його бота 6 були шкідливими — з вигаданими ролями, сумами й строками. Інший вимагав приймати кожен етап «за вимірюваним критерієм (точність на тестовому наборі), не за демонстрацією». Тестовий набір із 50–100 реальних запитань потрібен до запуску.
- Перевіряють відповідь, а не пошук. Якщо потрібний фрагмент не знайдено, модель уже не допоможе. У журналі має бути видно, що саме знайшла система.
- Немає сценарію «не знаю». Вимога з брифу: якщо відповіді немає в базі знань, AI має сказати про це, з’єднати з менеджером «і ні в якому разі не вигадувати». Це правило записують в інструкції й перевіряють на запитаннях, відповідей на які в базі свідомо немає.
- За документи ніхто не відповідає. Асистент не знає, що регламент застарів. Кожному документу потрібен власник, який його оновлює.
RAG зменшує кількість вигаданих відповідей, але не зводить її до нуля. Модель може неправильно прочитати знайдений фрагмент або поєднати два пункти, які один одного не стосуються. Тому посилання на джерело й журнал запитів — не прикраса, а спосіб контролю.
Що замовляють на українських біржах і скільки це коштує
Ми розібрали 187 AI-замовлень на Freelancehunt, Freelance.ua та Weblancer за червень–вересень 2026 року. RAG або векторний пошук прямо згадано в 14 з них. Асистент за базою знань для працівників — це 10 замовлень, і в цього сценарію найвища медіанна ціна серед усіх: близько 21 000 грн. Тут «ціна» — бюджет клієнта, а якщо його немає — медіана ставок фрилансерів. Вибірка мала, тож це орієнтир, а не статистика.
Що саме замовляли:
- асистента для операторів контакт-центру мережі медичних центрів — з вимогою не вигадувати ціни, виконавців і медичні показання;
- AI-агента для юридичної компанії: аналіз документів і законодавства, медіана ставок — 27 000 грн;
- Telegram-бота — помічника акаунт-менеджера, який відповідає на основі Google Docs;
- офлайн-AI для аналізу інженерної документації, медіана ставок — 25 000 грн;
- асистента-тьютора для онлайн-курсу мов, який не відповідає поза матеріалами курсу, — бюджет 25 000 грн.
| Варіант | Запуск | Щомісяця |
|---|---|---|
| Готовий інструмент (NotebookLM, проєкти в ChatGPT чи Claude) | підписка сервісу | підписка |
| Фрилансер з біржі | медіана ≈21 000 грн (10 замовлень) | як домовитеся |
| Студії, публічні прайси (вересень 2026) | 25–60 тис. грн | супровід у студій — 5–35 тис. грн/міс, окремо оплата моделі |
| Myrado: асистент за документами | від 35 000 грн, 10–14 днів | модель за фактом на вашому акаунті; супровід — за бажанням |
| Myrado: FAQ-бот для клієнтів на тій самій базі | від 25 000 грн, 7–10 днів | супровід від 3 000 грн/міс і модель за фактом |
Звідки ринкові цифри й чому вони так різняться, ми докладно розібрали в статті скільки коштує чат-бот і AI-агент.
Чекліст: чи готові ви до запуску
- Чи є список із 50–100 реальних запитань працівників або клієнтів?
- Чи зібрано актуальні версії документів в одному місці, а застарілі прибрано?
- Чи відомо, хто відповідає за кожен документ і оновлює його?
- Чи розпізнано скани і чи мають PDF текстовий шар?
- Чи визначено ролі: хто що має бачити?
- Чи є правило, кому передається запитання без відповіді?
- Чи зрозуміло, де асистент відповідатиме: у Telegram, Slack чи на сайті?
- Чи вирішено, які дані не можна передавати зовнішній моделі?
- Чи записано критерій приймання — наприклад, на скільки запитань із тестового набору асистент має відповісти правильно й із джерелом?
Якщо на перші три запитання відповідь «ні», почніть із них: це робота з документами, а не з AI, і розробник тут не допоможе.
Як ми робимо асистентів за документами
- Прототип до основної оплати. Беремо частину ваших документів і список реальних запитань та показуємо відповіді з посиланнями на джерела.
- Джерело в кожній відповіді. Назва документа й пункт. Якщо відповіді в документах немає, асистент так і каже й передає запитання відповідальному.
- Ролі й журнал. Кожен бачить лише дозволене, а керівник — що питають найчастіше й на що немає відповіді.
- Ваші акаунти. Моделі оплачуєте за фактом, без нашої націнки. NDA за потреби підписуємо до обміну документами.
- Фіксована ціна. Від 35 000 грн, запуск зазвичай за 10–14 днів, 30 днів доопрацювань включено.
Той самий принцип ми застосовуємо в себе. Голосовий AI-агент на номері студії відповідає лише з бази перевірених відповідей — станом на жовтень 2026 року їх близько 165. Пунктів, які ще не підтверджені, він не бачить узагалі, а коли відповіді немає, каже, що уточнить у розробника. Це простіший механізм, ніж векторний пошук, але правило те саме: спершу знайти перевірене джерело, потім говорити.
Якщо документів небагато й користується ними одна команда, чесно порадимо почати з готового інструмента. Демо й деталі — на сторінці чат-бота з базою знань.
Часті запитання
Що таке RAG простими словами?
RAG (retrieval-augmented generation) — це коли AI перед відповіддю шукає потрібні фрагменти у ваших документах і відповідає на їхній основі, а не із загальних знань моделі. Схоже на іспит із відкритим конспектом: модель добре формулює, а факти бере з ваших регламентів, договорів чи прайсу. Тому відповідь можна перевірити за посиланням на документ.
Чим RAG відрізняється від донавчання моделі (fine-tuning)?
RAG не змінює модель: він щоразу підкладає їй потрібні фрагменти документів, тому знання оновлюються разом із файлами, а до відповіді можна додати джерело. Донавчання змінює саму модель — її стиль, формат, термінологію. Для фактів, що часто змінюються (ціни, регламенти, умови), підходить RAG. Донавчання потрібне рідко й посилань на документи не дає.
Чи можна зробити чат-бота з базою знань самостійно?
Так, якщо документів небагато. Завантажте їх у NotebookLM або в проєкт у ChatGPT чи Claude й перевірте відповіді на 20–30 реальних запитаннях. Для FAQ на 30–50 запитань вистачить конструктора з AI-блоком, де всі відповіді вміщаються в інструкцію бота. Розробка потрібна, коли документів сотні, вони часто змінюються, потрібні доступи за ролями, журнал запитів і відповіді в Telegram, Slack чи на сайті.
Чи може AI з базою знань вигадати відповідь?
Може, хоча рідше, ніж без бази знань. Модель іноді неправильно читає знайдений фрагмент або відповідає, коли потрібного документа не знайшлося. Ризик зменшують так: правило «немає в документах — скажи про це й передай людині», посилання на джерело в кожній відповіді, тест на 50–100 реальних запитаннях до запуску й журнал запитів після нього.
Скільки коштує чат-бот з базою знань в Україні?
За нашим аналізом 187 AI-замовлень на українських біржах (червень–вересень 2026), медіанна ціна асистента за базою знань для працівників — близько 21 000 грн; вибірка мала, 10 замовлень. У публічних прайсах студій — 25–60 тис. грн. У Myrado асистент за документами з ролями доступу й журналом запитів коштує від 35 000 грн, запуск — зазвичай 10–14 днів. Використання моделі оплачується окремо, за фактом.
Чи безпечно передавати документи компанії в AI?
Залежить від того, як це зроблено. Перевірте три речі: чи навчається постачальник моделі на ваших даних (бізнес-API провайдерів зазвичай цього не роблять, але умови свого тарифу варто прочитати), хто з працівників які документи бачить і чи ведеться журнал запитів. Найчутливіші документи можна не включати в базу або розгорнути рішення на власній інфраструктурі.


