RAG — это когда AI не отвечает «с головы», а сначала ищет в ваших документах: регламентах, договорах, прайсах, инструкциях. Найденные фрагменты он получает вместе с вопросом и строит ответ только из них. Поэтому чат-бот с базой знаний называет вашу цену и ваш срок доставки, а не средние по интернету, и показывает, из какого документа это взял.
Ниже — как это устроено внутри, когда RAG не нужен и хватит готового инструмента, типичные ошибки и цены. Как выглядит готовое решение для команды, показано на странице AI-ассистента по документам компании.
Что такое RAG: определение и откуда термин
RAG (retrieval-augmented generation) — это архитектура, в которой языковая модель строит ответ не только из своих общих знаний, а из фрагментов ваших документов, найденных поиском под конкретный вопрос.
Название ввели исследователи Facebook AI Research (ныне Meta AI) с коллегами в статье 2020 года: они объединили языковую модель с поисковым индексом Википедии, чтобы она точнее отвечала на фактические вопросы. С тех пор это стандартный способ дать модели знания конкретной компании.
В названии три слова, и каждое — отдельный шаг:
- retrieval — поиск: система находит в базе фрагменты, близкие по смыслу к вопросу;
- augmented — дополнение: эти фрагменты добавляют к запросу, который получает модель;
- generation — генерация: модель формулирует ответ, опираясь на них.
Проще всего сравнить с экзаменом с открытым конспектом. Языковая модель — это студент, который хорошо формулирует, но ваших регламентов никогда не видел. RAG позволяет ему перед каждым ответом заглянуть в конспект. Если в конспекте ошибка или нужной страницы нет, ошибётся и студент.
Из этого следуют три практических вывода:
- Знания обновляются без переобучения. Заменили файл в папке — после синхронизации ассистент отвечает уже по новой версии.
- Ответ можно проверить. К нему добавляется название документа и пункт, так что человеку не нужно верить на слово.
- Качество зависит от поиска не меньше, чем от модели. Если система нашла не тот фрагмент, самая сильная модель ответит неправильно — уверенно и красивым языком.
В статье что такое AI-агент простыми словами мы называли знания одной из пяти составляющих агента. RAG — именно про неё.
Как работает чат-бот с базой знаний: путь одного вопроса
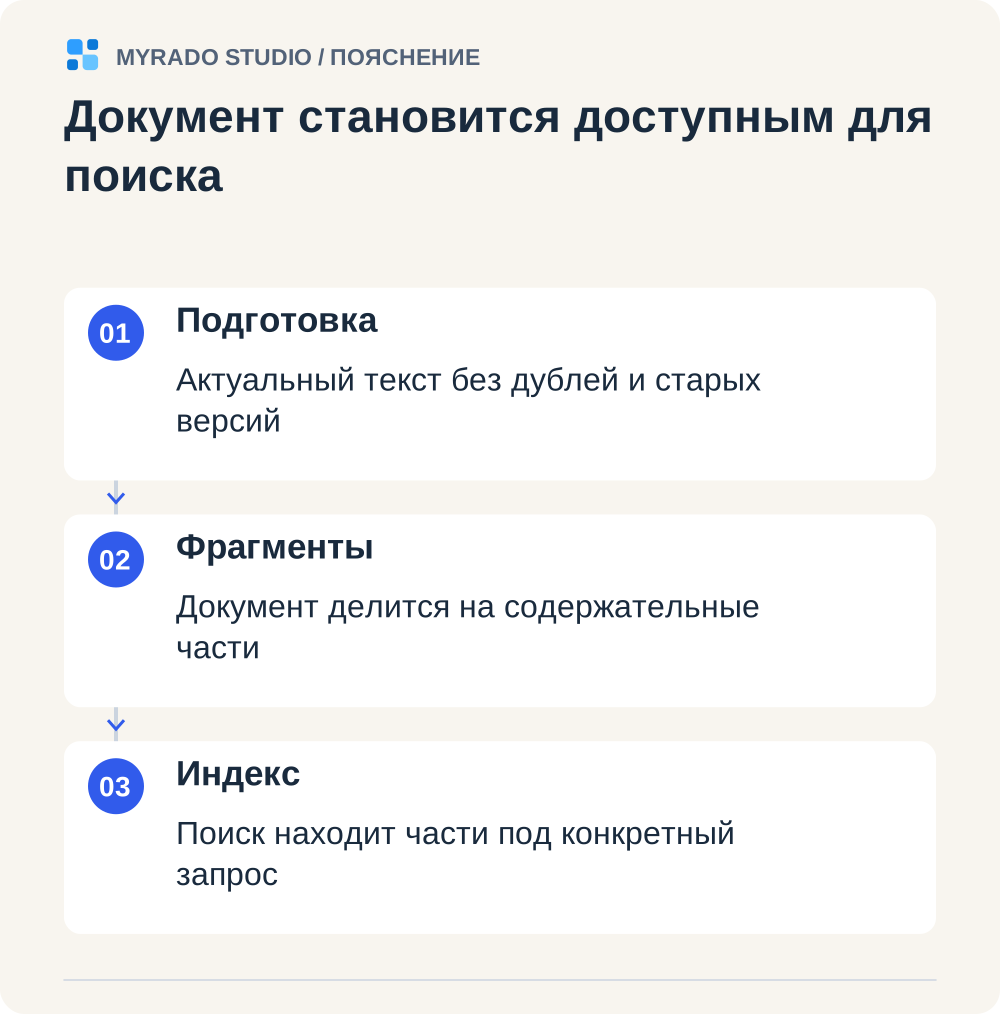
Работа делится на два этапа. Подготовка базы (шаги 1–4) выполняется один раз и повторяется, когда документы меняются. Ответ на вопрос (шаги 5–8) — каждый раз, когда кто-то пишет боту.
| Шаг | Что происходит | Где чаще всего ломается |
|---|---|---|
| 1. Сбор документов | Система забирает файлы из Google Drive, Notion, PDF-архива или с сайта | В базу попадают устаревшие версии и черновики |
| 2. Разбиение на фрагменты | Текст делят на куски по несколько сотен токенов: абзац, пункт, строка таблицы | Таблицу или пункт разрезали пополам, фрагмент остался без заголовка |
| 3. Эмбеддинги | Каждый фрагмент превращают в вектор — набор чисел, передающий смысл | Модель эмбеддингов плохо понимает украинский, артикулы и сокращения |
| 4. Индекс | Векторы хранят в векторной базе; рядом работает обычный поиск по словам | Нет метаданных: даты, отдела, уровня доступа |
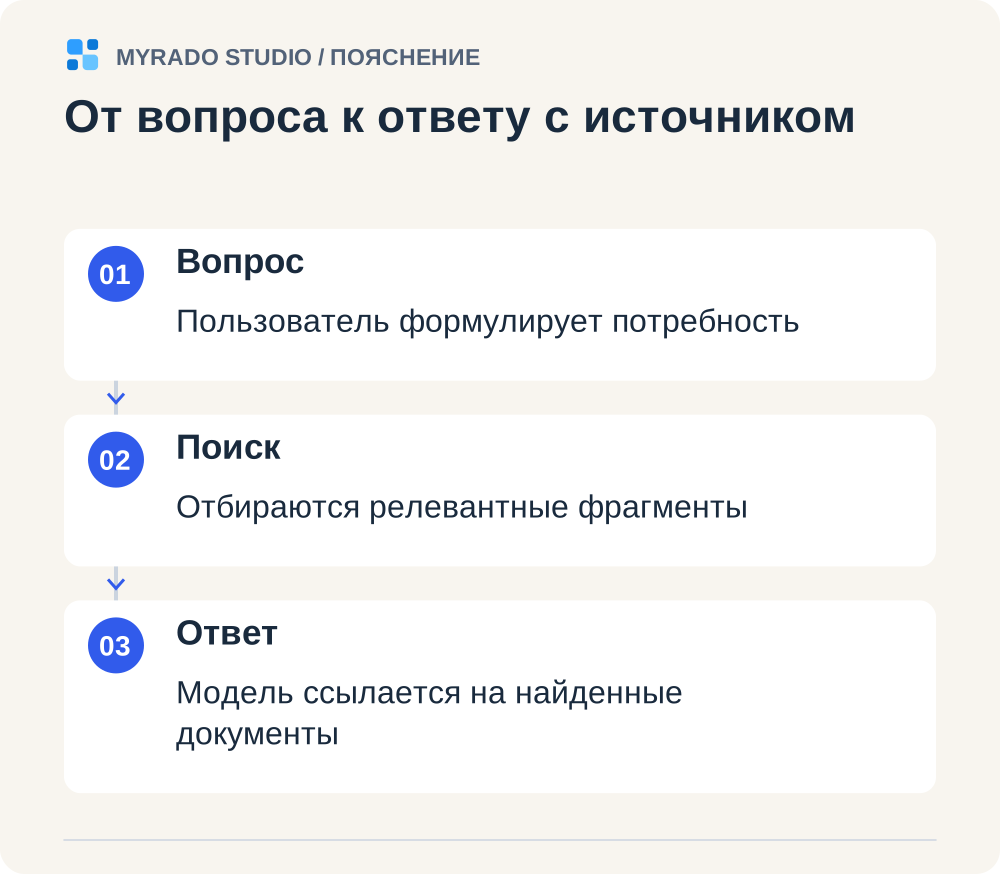
| 5. Поиск | На вопрос система находит обычно 5–20 ближайших фрагментов — по смыслу и по точным словам | Найдено похожее по теме, но не тот пункт |
| 6. Переранжирование | Отдельная модель пересортировывает найденное и оставляет самое уместное | Шаг пропускают, чтобы сэкономить |
| 7. Генерация | Модель получает вопрос, фрагменты и инструкцию: отвечай только по приведённому и ссылайся на источник | Нет правила «не знаешь — скажи», и модель додумывает |
| 8. Журнал | Вопрос, найденные фрагменты и ответ сохраняются для проверки | Журнала нет, поэтому ошибку не на чем показать |
Несколько пояснений к таблице.
Эмбеддинги нужны, чтобы искать по смыслу, а не по совпадению слов. «Отпуск частями» и «разделить отдых на две недели» не имеют общих слов, но их векторы близки — поэтому система найдёт нужный пункт регламента.
Векторная база — это хранилище таких векторов. В брифах, которые мы анализировали, заказчики чаще всего называют pgvector, Qdrant и Chroma. Для большинства компаний выбор базы значит меньше, чем качество разбиения документов на фрагменты.
Гибридный поиск объединяет поиск по смыслу с поиском по точным словам. Векторы хорошо ловят смысл, но хуже — артикул «KT-2207», номер договора или фамилию. Поэтому в рабочих системах работают сразу оба способа.
Насколько важна эта «кухня», показывают данные Anthropic за сентябрь 2024 года. Когда к каждому фрагменту добавляли краткий контекст и объединяли векторный поиск с поиском по словам, доля запросов, в которых нужный фрагмент не попал в двадцатку лучших, уменьшилась на 49%. С переранжированием — на 67%. Модель, которая пишет ответ, при этом не менялась.
Один вопрос шаг за шагом
Пример условный: магазин, документы и клиент выдуманы. На сайте магазина кофейного оборудования клиент пишет в чат: «Можно ли оплатить кофемолку частями и какая на неё гарантия?»
- Бот для клиентов имеет доступ только к публичным документам: условиям оплаты, гарантии, доставки. Внутренних регламентов и договоров с поставщиками в его базе нет.
- Поиск находит три фрагмента: раздел «Оплата частями» из условий оплаты, пункт о гарантии на кофемолки и общие гарантийные условия.
- Модель отвечает двумя предложениями и добавляет ссылки на обе страницы.
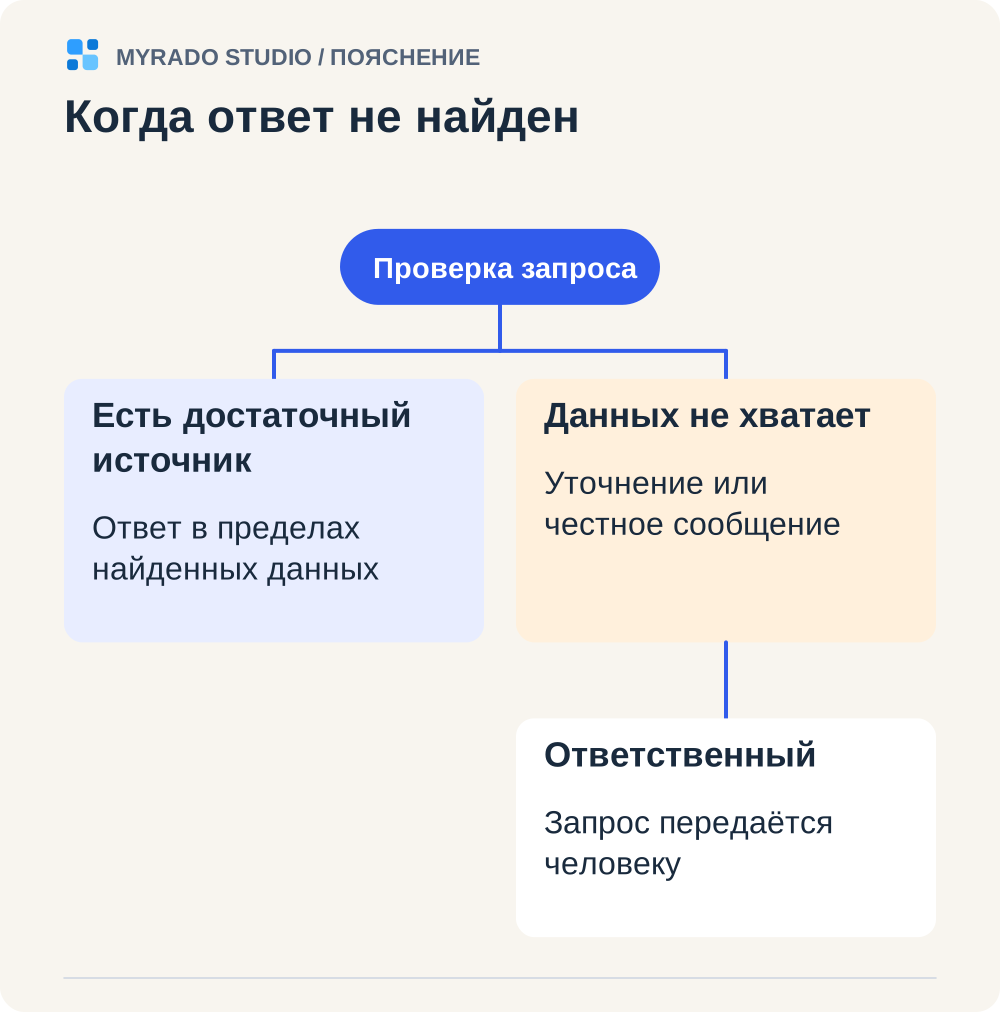
- Клиент спрашивает дальше: «А она подойдёт к моей кофеварке?» В документах о совместимости ничего нет. Бот так и говорит и передаёт разговор менеджеру с коротким резюме.
RAG, «всё в промпт» или дообучение: что выбрать
RAG — не единственный способ научить AI отвечать по вашим документам, и не всегда лучший.
| Всё в промпт | Готовый инструмент | RAG | Дообучение (fine-tuning) | |
|---|---|---|---|---|
| Как это выглядит | Весь текст базы каждый раз передаётся модели вместе с вопросом | NotebookLM, проекты в ChatGPT или Claude: загрузили файлы и спрашиваете | Система сама ищет нужные фрагменты и передаёт модели только их | Модель дополнительно тренируют на ваших примерах |
| Когда подходит | База до нескольких сотен страниц | Один человек или небольшая команда | Сотни и тысячи документов, частые изменения, разные доступы | Нужен особый стиль или формат, а не новые факты |
| Обновление знаний | Заменили текст — готово | Обычно файлы обновляют вручную | Синхронизация с источником | Новое обучение |
| Ссылка на источник | Если попросить в инструкции | Есть, в рамках инструмента | Да, до документа и пункта | Нет |
| Доступы по ролям | Нет | На уровне аккаунта или проекта | Да | Нет |
| Стоимость запроса | Растёт вместе с базой | Подписка | Небольшая: модель читает только найденное | Обучение и запросы |
Ориентир дала Anthropic в той же публикации 2024 года: если база знаний меньше 200 000 токенов — это примерно 500 страниц, — её можно целиком передавать модели, и RAG не нужен. С тех пор контекстные окна выросли: у актуальных моделей Claude это до 1 млн токенов (документация Anthropic, октябрь 2026 года). Но «влезает» не значит «выгодно»: чем больше текста в каждом запросе, тем дороже и медленнее каждый ответ, а разграничить доступы так не получится.
У готовых инструментов свои пределы. Например, в NotebookLM один источник — это до 500 000 слов или файл до 200 МБ (справка Google, октябрь 2026 года).
Дообучение часто путают с RAG. Оно меняет поведение модели — тон, формат, терминологию, — но плохо подходит для фактов, которые меняются. Чтобы обновить прайс, модель пришлось бы тренировать заново, а сослаться на документ она не сможет.
Когда RAG не нужен и что можно сделать самому
Разработка ассистента по документам оправдана не всегда. Вот четыре ситуации, где она лишняя.
Документов немного, и пользуется ими одна команда. Попробуйте готовый инструмент:
- Соберите актуальные версии документов в одну папку.
- Загрузите их в NotebookLM или в проект в ChatGPT или Claude.
- Задайте 20–30 вопросов, которые сотрудники действительно задают, и проверьте каждый ответ по источнику.
- Если результат устраивает — возможно, больше ничего не нужно.
Перед загрузкой договоров и персональных данных прочитайте условия своего тарифа: правила хранения и использования данных у разных сервисов и планов разные.
Нужен FAQ-бот на 30–50 вопросов. Таблица «вопрос — ответ» целиком помещается в инструкцию бота, и поиск здесь не нужен. Хватит конструктора с AI-блоком или простого чат-бота для сайта.
Ответ живёт в системе, а не в документе. Остаток на складе, статус заказа, долг клиента — это запрос к CRM или 1С/BAS через API, а не поиск по текстам. Такие задачи описаны на странице интеграций AI с 1С, BAS и CRM.
Документы противоречат друг другу. Если на сайте одна цена, а в прайсе другая, ассистент честно найдёт обе. Сначала стоит навести порядок в документах.
А вот признаки, что RAG нужен:
- документов сотни и больше, и они обновляются каждую неделю;
- разные люди должны видеть разное: продавец — прайс, бухгалтер — договоры;
- в ответе нужна ссылка на документ и пункт;
- ассистент должен отвечать в Telegram, Slack или на сайте, а не в личном аккаунте сотрудника;
- руководителю нужен журнал: что спрашивают и на что в документах нет ответа.
Типичные ошибки в проектах с базой знаний
- Загрузили всё подряд. Черновики, старые версии и дубликаты попадают в базу наравне с действующими документами, и ассистент цитирует то, что нашёл первым.
- Сканы без распознавания. PDF без текстового слоя для поиска пуст. Сканы сначала распознают, и чем чётче скан, тем лучше ответ.
- Прайсы и таблицы порезаны на куски. Название товара оказалось в одном фрагменте, цена — в другом. Таблицы лучше хранить как таблицы и искать в них точно, а не «по смыслу».
- Нет прав доступа. В одном из брифов на бирже заказчик отдельно требовал отзывать доступ у уволенных сотрудников. О ролях стоит подумать до запуска, а не после первой утечки.
- Качество оценивают «на глаз». Один заказчик посчитал: из 81 ответа его бота 6 были вредными — с выдуманными ролями, суммами и сроками. Другой требовал принимать каждый этап «по измеримому критерию (точность на тестовом наборе), не по демонстрации». Тестовый набор из 50–100 реальных вопросов нужен до запуска.
- Проверяют ответ, а не поиск. Если нужный фрагмент не найден, модель уже не поможет. В журнале должно быть видно, что именно нашла система.
- Нет сценария «не знаю». Требование из брифа: если ответа нет в базе знаний, AI должен сказать об этом, соединить с менеджером «и ни в коем случае не выдумывать». Это правило записывают в инструкции и проверяют на вопросах, ответов на которые в базе заведомо нет.
- За документы никто не отвечает. Ассистент не знает, что регламент устарел. У каждого документа должен быть владелец, который его обновляет.
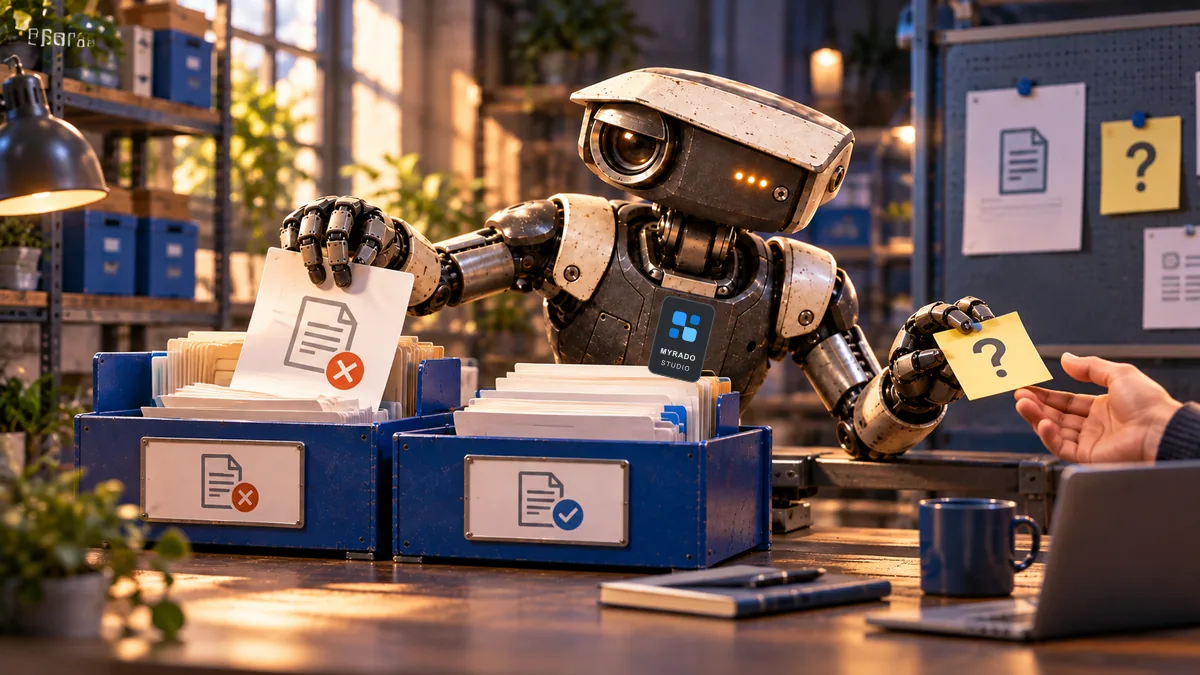
RAG уменьшает количество выдуманных ответов, но не сводит его к нулю. Модель может неправильно прочитать найденный фрагмент или объединить два пункта, которые друг к другу не относятся. Поэтому ссылка на источник и журнал запросов — не украшение, а способ контроля.
Что заказывают на украинских биржах и сколько это стоит
Мы разобрали 187 AI-заказов на Freelancehunt, Freelance.ua и Weblancer за июнь–сентябрь 2026 года. RAG или векторный поиск напрямую упомянуты в 14 из них. Ассистент по базе знаний для сотрудников — это 10 заказов, и у этого сценария самая высокая медианная цена среди всех: около 21 000 грн. Здесь «цена» — бюджет клиента, а если его нет — медиана ставок фрилансеров. Выборка небольшая, так что это ориентир, а не статистика.
Что именно заказывали:
- ассистента для операторов контакт-центра сети медицинских центров — с требованием не выдумывать цены, исполнителей и медицинские показания;
- AI-агента для юридической компании: анализ документов и законодательства, медиана ставок — 27 000 грн;
- Telegram-бота — помощника аккаунт-менеджера, который отвечает на основе Google Docs;
- офлайн-AI для анализа инженерной документации, медиана ставок — 25 000 грн;
- ассистента-тьютора для онлайн-курса языков, который не отвечает вне материалов курса, — бюджет 25 000 грн.
| Вариант | Запуск | Ежемесячно |
|---|---|---|
| Готовый инструмент (NotebookLM, проекты в ChatGPT или Claude) | подписка сервиса | подписка |
| Фрилансер с биржи | медиана ≈21 000 грн (10 заказов) | как договоритесь |
| Студии, публичные прайсы (сентябрь 2026) | 25–60 тыс. грн | сопровождение у студий — 5–35 тыс. грн/мес, отдельно оплата модели |
| Myrado: ассистент по документам | от 35 000 грн, 10–14 дней | модель по факту на вашем аккаунте; сопровождение — по желанию |
| Myrado: FAQ-бот для клиентов на той же базе | от 25 000 грн, 7–10 дней | сопровождение от 3 000 грн/мес и модель по факту |
Откуда рыночные цифры и почему они так различаются, мы подробно разобрали в статье сколько стоит чат-бот и AI-агент.
Чеклист: готовы ли вы к запуску
- Есть ли список из 50–100 реальных вопросов сотрудников или клиентов?
- Собраны ли актуальные версии документов в одном месте, а устаревшие убраны?
- Известно ли, кто отвечает за каждый документ и обновляет его?
- Распознаны ли сканы и есть ли у PDF текстовый слой?
- Определены ли роли: кто что должен видеть?
- Есть ли правило, кому передаётся вопрос без ответа?
- Понятно ли, где ассистент будет отвечать: в Telegram, Slack или на сайте?
- Решено ли, какие данные нельзя передавать внешней модели?
- Записан ли критерий приёмки — например, на сколько вопросов из тестового набора ассистент должен ответить правильно и с источником?
Если на первые три вопроса ответ «нет», начните с них: это работа с документами, а не с AI, и разработчик здесь не поможет.
Как мы делаем ассистентов по документам
- Прототип до основной оплаты. Берём часть ваших документов и список реальных вопросов и показываем ответы со ссылками на источники.
- Источник в каждом ответе. Название документа и пункт. Если ответа в документах нет, ассистент так и говорит и передаёт вопрос ответственному.
- Роли и журнал. Каждый видит только разрешённое, а руководитель — что спрашивают чаще всего и на что нет ответа.
- Ваши аккаунты. Модели оплачиваете по факту, без нашей наценки. NDA при необходимости подписываем до обмена документами.
- Фиксированная цена. От 35 000 грн, запуск обычно за 10–14 дней, 30 дней доработок включено.
Тот же принцип мы применяем у себя. Голосовой AI-агент на номере студии отвечает только из базы проверенных ответов — по состоянию на октябрь 2026 года их около 165. Пунктов, которые ещё не подтверждены, он не видит вообще, а когда ответа нет, говорит, что уточнит у разработчика. Это более простой механизм, чем векторный поиск, но правило то же: сначала найти проверенный источник, потом говорить.
Если документов немного и пользуется ими одна команда, честно посоветуем начать с готового инструмента. Демо и детали — на странице чат-бота с базой знаний.
Частые вопросы
Что такое RAG простыми словами?
RAG (retrieval-augmented generation) — это когда AI перед ответом ищет нужные фрагменты в ваших документах и отвечает на их основе, а не из общих знаний модели. Похоже на экзамен с открытым конспектом: модель хорошо формулирует, а факты берёт из ваших регламентов, договоров или прайса. Поэтому ответ можно проверить по ссылке на документ.
Чем RAG отличается от дообучения модели (fine-tuning)?
RAG не меняет модель: он каждый раз подкладывает ей нужные фрагменты документов, поэтому знания обновляются вместе с файлами, а к ответу можно добавить источник. Дообучение меняет саму модель — её стиль, формат, терминологию. Для фактов, которые часто меняются (цены, регламенты, условия), подходит RAG. Дообучение нужно редко и ссылок на документы не даёт.
Можно ли сделать чат-бота с базой знаний самостоятельно?
Да, если документов немного. Загрузите их в NotebookLM или в проект в ChatGPT или Claude и проверьте ответы на 20–30 реальных вопросах. Для FAQ на 30–50 вопросов хватит конструктора с AI-блоком, где все ответы помещаются в инструкцию бота. Разработка нужна, когда документов сотни, они часто меняются, нужны доступы по ролям, журнал запросов и ответы в Telegram, Slack или на сайте.
Может ли AI с базой знаний выдумать ответ?
Может, хотя реже, чем без базы знаний. Модель иногда неправильно читает найденный фрагмент или отвечает, когда нужного документа не нашлось. Риск уменьшают так: правило «нет в документах — скажи об этом и передай человеку», ссылка на источник в каждом ответе, тест на 50–100 реальных вопросах до запуска и журнал запросов после него.
Сколько стоит чат-бот с базой знаний в Украине?
По нашему анализу 187 AI-заказов на украинских биржах (июнь–сентябрь 2026), медианная цена ассистента по базе знаний для сотрудников — около 21 000 грн; выборка небольшая, 10 заказов. В публичных прайсах студий — 25–60 тыс. грн. В Myrado ассистент по документам с ролями доступа и журналом запросов стоит от 35 000 грн, запуск — обычно 10–14 дней. Использование модели оплачивается отдельно, по факту.
Безопасно ли передавать документы компании в AI?
Зависит от того, как это сделано. Проверьте три вещи: обучается ли поставщик модели на ваших данных (бизнес-API провайдеров обычно этого не делают, но условия своего тарифа стоит прочитать), кто из сотрудников какие документы видит и ведётся ли журнал запросов. Самые чувствительные документы можно не включать в базу или развернуть решение на собственной инфраструктуре.


